ChatGPT, Claude или Gemini: какой ИИ дешевле для текстов на узбекском языке?
Технологическая компания Gorgona AI изучила, какая модель искусственного интеллекта обходится дешевле при обработке текстов на узбекском языке.
В исследовании, в котором сравнивались девять моделей, разница между самым дешёвым и самым дорогим вариантами достигла почти 40 раз.
Даже у моделей GPT-5.6 Sol и Claude Opus 5.5, стоимость токенов которых одинакова, расходы различались на 70%.
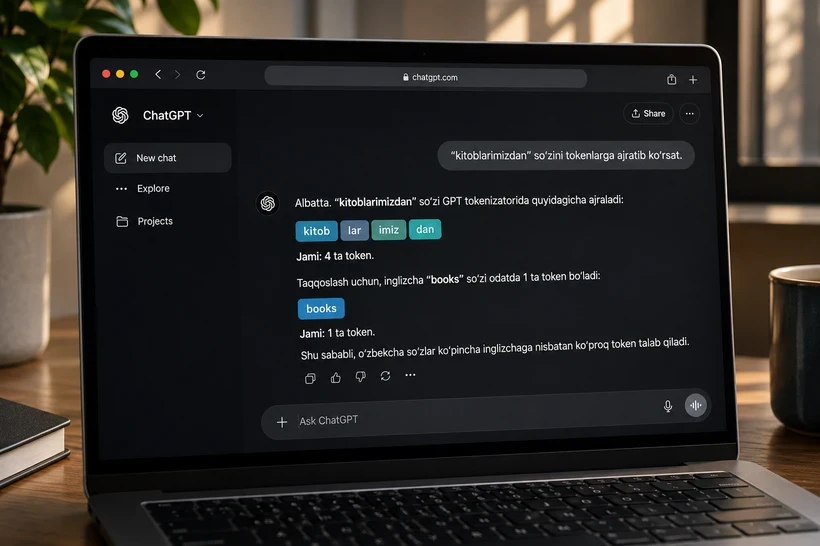
Узбекская технологическая компания Gorgona AI опубликовала исследование под названием «Один смысл, разная цена: сколько стоит узбекский язык для искусственного интеллекта?». В его рамках 1 337 текстов с одинаковым содержанием проверили с помощью 15 токенизаторов.
Исследование показало, что, несмотря на установление крупными ИИ-компаниями одинаковой стоимости токенов для всех языков, тексты на узбекском языке занимают больше токенов, чем английские. В результате за обработку текстов с одинаковым содержанием приходится платить больше.
Токен — это единица, которую искусственный интеллект использует при обработке текста. Модель воспринимает текст не целыми словами или буквами, а фрагментами, на которые его разделяет токенизатор. В API-сервисах оплата обычно рассчитывается в зависимости от количества использованных токенов.
Проблема заключается в том, что при разработке большинства крупных моделей использовалось больше данных на английском языке. Поэтому английские слова часто занимают один токен, тогда как узбекские слова вместе с суффиксами в среднем разделяются почти на три токена.
Например, слово «китобларимиздан» («из наших книг») в токенизаторе OpenAI может разделяться на пять токенов. Это связано как с особенностями структуры узбекского языка, так и с недостаточным представлением узбекских слов и суффиксов в словаре токенизатора.
Какие модели ИИ расходуют больше токенов на узбекский язык?
Измерения Gorgona AI на наборе текстов FLORES показали следующие результаты:
ИИ-провайдер | Количество токенов по сравнению с английским |
OpenAI | 1,78 раза |
Google Gemini 3.8 Flash | 1,90 раза |
Anthropic Claude | 1,93 раза |
Google Gemini 4 Argon | 1,95 раза |
Qwen | 2,04 раза |
DeepSeek | 2,13 раза |
Показатели рассчитаны на основе сравнения вариантов текстов с одинаковым содержанием на узбекском языке в латинской графике и английском языке. В других наборах текстов разница составляла от 1,55 до 2,17 раза.
Тексты на узбекском языке также требовали в 1,24–1,54 раза больше токенов по сравнению с русским языком.
Исследователи также обнаружили различия между текстами, изначально написанными на узбекском языке, и текстами, переведёнными с английского. В первом случае дополнительные расходы были относительно ниже, тогда как во втором — выше.
Даже при одинаковой стоимости токенов итоговые расходы различаются на 70%
Одним из наиболее интересных результатов исследования стало сравнение моделей OpenAI и Anthropic.
Согласно расчётам Gorgona AI, стоимость одного миллиона токенов у моделей Claude Opus 5.5 и GPT-5.6 Sol была одинаковой. Однако при обработке одного и того же узбекского текста токенизатор Claude расходовал на 70% больше токенов.
Например, обработка узбекского перевода текста объёмом 1 млн слов на английском языке оценивалась следующим образом:
- Claude Opus 5.5 — 14,78 доллара;
- GPT-5.6 Sol — 8,70 доллара.
Поэтому исследователи рекомендуют компаниям выбирать модели ИИ не только на основании стоимости одного миллиона токенов, но и с учётом итоговой стоимости обработки собственных текстов.
Ответы на узбекском языке также обходятся дороже
Расходы не ограничиваются только текстом, который отправляется искусственному интеллекту.
Gorgona AI поручила моделям GPT-5.6 Luna и Claude Haiku 5.5 кратко излагать тексты с одинаковым содержанием и отвечать на вопросы.
В результате создание видимых пользователю ответов на узбекском языке обходилось в 1,7–1,8 раза дороже, чем на английском. При этом количество символов в ответах было практически одинаковым.
У модели Claude Haiku 5.5 выявили дополнительную разницу. При ответах на некоторые запросы на узбекском языке модель использовала больше токенов для внутренних рассуждений, которые не видны пользователю. В результате, если учитывать и эти токены, стоимость ответов увеличивалась в 2,1–2,3 раза по сравнению с английским языком.
Однако исследователи подчеркнули, что эти результаты относятся только к проверенным моделям и задачам. Их нельзя распространять на все модели искусственного интеллекта.
Расходы на кириллицу и латиницу также различаются
В исследовании также сравнивались кириллическая и латинская графики узбекского языка.
В моделях Claude обе системы письма требовали практически одинакового количества токенов. У других провайдеров разница достигала 7–23%.
Кроме того, выяснилось, что различное написание апострофа в узбекских латинских буквах «oʻ» и «gʻ» также влияет на количество токенов. Использование единого варианта апострофа в некоторых случаях позволяет сэкономить до 5% токенов.
Исследователи также рассчитали влияние предложенных изменений в узбекском латинском алфавите. Согласно их оценкам, замена сочетаний «oʻ», «gʻ», «sh» и «ch» на «ö», «ğ», «ş» и «ç» соответственно позволяет сократить количество токенов на 2–4% в моделях Claude, Gemini и Qwen.
В моделях OpenAI и DeepSeek существенных изменений не наблюдалось.